



🔸 SQL সম্পর্কিত প্রশ্ন ও উত্তরঃ
প্রশ্ন ১: SQL কী?
উত্তর:
SQL (Structured Query Language) হলো একটি স্ট্যান্ডার্ড ল্যাঙ্গুয়েজ যা ডেটাবেইসে ডেটা insert, update, delete এবং query করার জন্য ব্যবহৃত হয়।
প্রশ্ন ২: SELECT, INSERT, UPDATE ও DELETE এর কাজ কী?
উত্তর:
SELECT– ডেটাবেইস থেকে ডেটা পড়তে ব্যবহৃত হয়
INSERT– নতুন ডেটা যোগ করতে ব্যবহৃত হয়
UPDATE– বিদ্যমান ডেটা আপডেট করতে ব্যবহৃত হয়
DELETE– ডেটা মুছে ফেলতে ব্যবহৃত হয়
প্রশ্ন ৩: WHERE এবং HAVING এর মধ্যে পার্থক্য কী?
উত্তর:
WHERE ব্যবহার হয় row ফিল্টার করার জন্য এবং এটি GROUP BY এর আগে ব্যবহৃত হয়।
HAVING ব্যবহার হয় aggregate result (যেমন COUNT(), SUM()) ফিল্টার করতে এবং এটি GROUP BY এর পরে ব্যবহৃত হয়।
প্রশ্ন ৪: GROUP BY কী কাজে লাগে?
উত্তর:
GROUP BY ব্যবহৃত হয় এক বা একাধিক কলামের উপর ভিত্তি করে ডেটা গ্রুপ করতে, সাধারণত aggregate function এর সাথে।
প্রশ্ন ৫: Index কী এবং কেন ব্যবহৃত হয়?
উত্তর:
Index হলো ডেটাবেইসের একটি ডেটা স্ট্রাকচার যা দ্রুত সার্চ ও রিট্রাইভাল সুবিধা দেয়। এটি query execution দ্রুত করতে সাহায্য করে।
🔸 ডেটাবেইস ডিজাইন ও কনসেপ্ট প্রশ্নঃ
প্রশ্ন ৬: Normalization কী?
উত্তর:
Normalization হলো একটি প্রক্রিয়া যা ডেটাবেইসকে redundancy (একই ডেটা বারবার রাখা) কমিয়ে এবং ডেটা integrity বাড়িয়ে অপ্টিমাইজ করে।
প্রশ্ন ৭: 1NF, 2NF, 3NF কী?
উত্তর:
1NF: প্রতিটি সেল এ্যাটমিক ভ্যালু রাখে
2NF: 1NF + সম্পূর্ণ primary key নির্ভরশীলতা
3NF: 2NF + ট্রানজিটিভ নির্ভরশীলতা দূর করা
প্রশ্ন ৮: Primary Key এবং Unique Key এর পার্থক্য কী?
উত্তর:
- Primary Key – প্রতিটি row কে ইউনিকভাবে শনাক্ত করে, null থাকতে পারে না
- Unique Key – ইউনিক মান রাখতে পারে, তবে একবার null থাকতে পারে
প্রশ্ন ৯: Foreign Key কী?
*উত্তর: *
একটি টেবিলের কলাম যা অন্য টেবিলের Primary Key কে রেফার করে, এটাকে Foreign Key বলে।
প্রশ্ন ১০: ACID মানে কী?
উত্তর:
- A – Atomicity
- C – Consistency
- I – Isolation
- D – Durability
এই গুণাবলি ডেটাবেইস ট্রানজ্যাকশনগুলোর বিশ্বাসযোগ্যতা ও সঠিকতা নিশ্চিত করে।
🔸 SQL JOIN সম্পর্কিত প্রশ্ন ও উত্তরঃ
প্রশ্ন ১১: SQL JOIN কী?
উত্তর:
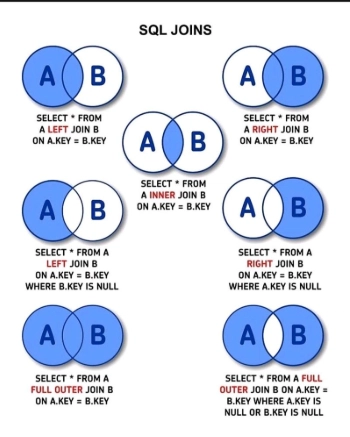
JOIN ব্যবহার করে একাধিক টেবিল থেকে সম্পর্কযুক্ত ডেটা একত্রে আনা হয়।
প্রশ্ন ১২: INNER JOIN কী?
উত্তর:
দুই টেবিলের যেসব রেকর্ড ম্যাচ করে কেবল সেগুলোই দেখায়।
প্রশ্ন ১৩: LEFT JOIN এবং RIGHT JOIN এর পার্থক্য কী?
উত্তর:
LEFT JOIN: বাম টেবিলের সব রেকর্ড এবং ডান টেবিলের ম্যাচ করা রেকর্ড
RIGHT JOIN: ডান টেবিলের সব রেকর্ড এবং বাম টেবিলের ম্যাচ করা রেকর্ড
প্রশ্ন ১৪: FULL OUTER JOIN কী করে?
উত্তর:
দুই টেবিলের সব রেকর্ড দেখায়, যদি না ম্যাচ করে তবে null দেখায়।
প্রশ্ন ১৫: SELF JOIN কী?
উত্তর:
যখন একটি টেবিলকে নিজের সাথেই JOIN করা হয় তখন তাকে SELF JOIN বলে। সাধারণত হায়ারার্কিকাল ডেটা (যেমন employee-manager) এর জন্য ব্যবহৃত হয়।
প্রশ্ন 16: View এবং Materialized View এর মধ্যে পার্থক্য কী?
উত্তর:
Viewহলো একটি ভার্চুয়াল টেবিল যা একটি SQL query এর উপর ভিত্তি করে তৈরি হয়। এতে মূল ডেটা থাকে না, কেবল query চলে।
Materialized Viewহলো এমন একটি ভিউ যেটি query এর রেজাল্টকে ফিজিক্যালি স্টোর করে রাখে, ফলে দ্রুত অ্যাক্সেস পাওয়া যায়।
প্রশ্ন 17: Stored Procedure ও Function এর মধ্যে পার্থক্য কী?
উত্তর:
Stored Procedureএকাধিক স্টেটমেন্টের সমন্বয়ে তৈরি এবং এটি return না-ও করতে পারে।
Functionসর্বদা একটি মান return করে এবং সাধারণত SELECT statement এর মধ্যে ব্যবহার হয়।
প্রশ্ন 18: Index কীভাবে কাজ করে? এবং কখন Index ব্যবহার করা উচিত নয়?
উত্তর:
Index ডেটা স্ট্রাকচার (যেমন B-Tree) ব্যবহার করে সার্চ অপারেশন দ্রুত করে।
Index ব্যবহার করা উচিত নয় যদি:
- আপনি খুবই ছোট টেবিল নিয়ে কাজ করছেন
- আপনি প্রচুর insert/update/delete করছেন (কারণ এগুলো index রিফ্রেশ করতে হয়)
- আপনি এমন কলামে index করছেন যেখানে ভ্যালুগুলোর ভ্যারিয়েশন খুব কম (low cardinality)
প্রশ্ন 19: Query Optimization কীভাবে করবেন?
উত্তর:
- প্রয়োজনহীন
SELECT *বাদ দিয়ে নির্দিষ্ট কলাম বেছে নিন - Index ব্যবহার করুন
- Subquery এর বদলে JOIN ব্যবহার করুন
Query Execution Plan (EXPLAIN)দেখে বুঝুন কোথায় সময় বেশি লাগছে- Aggregate query গুলোতে GROUP BY সাবধানে ব্যবহার করুন
প্রশ্ন 20: Database Sharding ও Replication এর মধ্যে পার্থক্য কী?
উত্তর:
Sharding: ডেটা কে horizontally বিভিন্ন সার্ভারে ভাগ করে রাখে (বড় ডেটাবেইসে লোড কমাতে)
Replication: একই ডেটা একাধিক সার্ভারে কপি করে রাখা হয় (failover ও read-performance বাড়াতে)
প্রশ্ন 21: Deadlock কী এবং এটি কীভাবে হ্যান্ডেল করবেন?
উত্তর:
Deadlock তখন ঘটে যখন দুটি বা ততোধিক ট্রানজ্যাকশন একে অপরের রিসোর্সের জন্য অপেক্ষা করতে থাকে এবং কেউই কাজ শেষ করতে পারে না।
Deadlock হ্যান্ডেল করার উপায়ঃ
- লক নেবার order ঠিক রাখা
- ছোট transaction রাখা
- Retry mechanism যুক্ত করা
- Timeout ব্যবহার করা
প্রশ্ন 22: ORM (যেমন Eloquent) ব্যবহার করলে performance issue হতে পারে কেন?
উত্তর:
- Eager loading না করলে N+1 problem হয়
- Unnecessary query generate হয় যদি যথাযথভাবে scope বা relationship define না করা হয়
- Raw SQL বা optimized query ব্যবহারে performance অনেক বেড়ে যেতে পারে ORM এর তুলনায়
প্রশ্ন 23: Eager Loading vs Lazy Loading — পার্থক্য কী?
উত্তর:
Eager Loading: একসাথে related ডেটা লোড করে (query optimization friendly)
Lazy Loading: যখন প্রয়োজন হয় তখন related ডেটা লোড করে (ধীরে কাজ করে, N+1 problem হতে পারে)
প্রশ্ন 24: Transaction isolation level গুলো কী কী?
উত্তর:
Read Uncommitted:অন্য ট্রানজ্যাকশন থেকে uncommitted ডেটা পড়া যায় (Dirty Read)
Read Committed: কেবল committed ডেটা পড়ে
Repeatable Read: একই query বারবার করলে একই রেজাল্ট পাবেন
Serializable: সর্বোচ্চ নিরাপত্তা, ট্রানজ্যাকশন একে অপরের মতো behave করে যেন সিঙ্গেল থ্রেডে হচ্ছে
প্রশ্ন 25: “EXPLAIN” কমান্ড কী এবং এটি কেন ব্যবহার করা হয়?
উত্তর:
EXPLAIN কমান্ড দিয়ে SQL query এর execution plan দেখা যায়। এটি দেখায় কোন টেবিল কখন স্ক্যান হচ্ছে, কোন index ব্যবহার হচ্ছে ইত্যাদি — performance tuning এর জন্য এটি খুব গুরুত্বপূর্ণ।
প্রশ্ন 26: SQL এর ক্যাটাগরিগুলো ও তাদের কাজ?
উত্তর:
i. DDL (Data Definition Language)
👉 উদ্দেশ্য: ডেটাবেইসের স্ট্রাকচার বা স্কিমা তৈরি ও পরিবর্তন করা।

ii. DML (Data Manipulation Language)
👉 উদ্দেশ্য: ডেটা ইনসার্ট, আপডেট বা ডিলিট করা।


SOCIAL SHARE CARD GENERATOR